基幹システムを改修せずにAIを入れるには、基幹には書き込まず、CSV出力・読み取り専用の接続・レプリカのどれかで中間の置き場にデータの写しを作り、AIにはその写しだけを読ませます。写しの置き場は、件数・更新の頻度・使う部署の数の3つで、表計算・業務アプリ・データウェアハウスから選びます。改修の予算も期間も無いまま、現場からAIで社内データを使いたいと言われている情報システム責任者に向けて、その構成と選び方を整理します。
- AIを基幹に直接つながず、基幹からは読むだけで写しを作り、AIは写しだけを読む構成にします。基幹の画面や処理には手を入れません。
- 「読み取り専用」はAIのツール側の表示では守れません。DBの読むだけのユーザか、読み取り専用のレプリカの側で守ります。
- 写しは元と同時刻ではありません。置き場は件数・更新の頻度・使う部署の数で決め、AIの答えには何時点の数字かを添えます。
基幹を改修せずにAIを入れるとき、どんな構成にするか
構成は、基幹・読み出し・中間の置き場・AIの4つの箱で描きます。基幹から読むだけでデータを取り出し、置き場に写しを作り、AIはその写しに対して質問に答えます。AIと基幹のあいだに線を直接引かないことが、この構成の要点です。
箱の間には、次の3つの決まりを置きます。
| 決まり | 中身 | 守れないと起きること |
|---|---|---|
| 基幹には書き込まない | 読み出しは読むだけの権限で行い、登録・更新・削除はしない | AIや取り込みの処理が、基幹の数字を変えてしまう |
| AIは写しだけを読む | AIの接続先は中間の置き場だけにし、基幹の接続情報をAIに渡さない | AIの問い合わせが本番の処理と同じ時間帯にぶつかる |
| 基幹を社外に開けない | 写しは社内から外へ送り出す向きで作り、外から基幹に入る口を作らない | AIのために、基幹への入口をインターネット側に開けることになる |
対象は、AIが読むだけの構成です。AIに基幹への登録や更新をさせる構成は、権限・二重登録・承認の決め方が別に要るため、ここでは扱いません。
「触れない基幹」とはどんな状態か
経済産業省の総括レポートは、レガシーシステムを、運用維持保守や機能改良が困難な状態に陥ったシステムと定義しています。あわせて、仕様や設計のドキュメントが整備されておらず、移行や再構築に支障が出る状態をブラックボックス化の例に挙げています。改修の見積が高くつく基幹の多くは、このどちらかに当たります。
仮の場面として、営業部から受注と在庫をAIに聞けるようにしたいと言われ、保守会社に相談すると基幹の画面と処理の改修見積が返ってくる状況を考えます。このとき頼むべきなのは改修ではなく、基幹からデータを読み出す方法の確認です。何を確かめるかは最後の節にまとめます。
基幹からデータを読み出す方法は、3つのどれを選ぶか
基幹からの読み出し方は、CSV出力(基幹の機能で出すだけで、鮮度は出す頻度で決まる)、読み取り専用の接続(読むだけのユーザで基幹のDBを直接読み、本番に負荷がかかる)、レプリカ/ミラーリング(読み取り専用の写しを別に持ち、非同期なので少し遅れる)の3通りです。
| 読み出し方 | 基幹への負荷 | 写しの鮮度 | 読み取り専用をどこで守るか |
|---|---|---|---|
| CSV出力 | 出力する時間だけ。夜間など時間帯を選べる | 最後に出した時点まで。1日1回なら前日分 | 基幹は出すだけ。写しを置く場所の権限で守る |
| 読み取り専用の接続 | 読むたびに本番のDBに問い合わせがかかる | 読んだ時点の値 | DBに作る読むだけのユーザ・ロール |
| レプリカ/ミラーリング | 問い合わせは写しに向くので、本番の負荷を減らせる | 非同期で複製されるため、元より少し遅れる | 写しそのものが読み取り専用 |
CSV出力は、基幹にもともと帳票や一覧の書き出し機能があれば、設定を変えずに始められます。弱いのは鮮度で、出す頻度より新しい数字はAIに渡りません。
読み取り専用の接続は、いちばん新しい数字を読めます。そのかわり、取り込みやAIの問い合わせが本番のDBに直接かかります。月末の締めなど基幹が混む時間帯と重ならないよう、読む時間を決めておく必要があります。
レプリカは、元のDBの読み取り専用のコピーです。Amazon RDS のリードレプリカは、問い合わせを写しに振り向けて元の負荷を減らせる一方、元の更新は非同期でコピーされます。Microsoft Fabric のミラーリングのように、既存のDBから分析用の置き場へ継続的に複製する仕組みもあります。
基幹を外に開けずに写しを出す
基幹が社内のサーバーにある場合、写しをクラウドの置き場に出すときも、外から基幹へ入る口を作る必要はありません。Microsoft のオンプレミス データ ゲートウェイは、社内から外向きに接続してクラウドとつながる仕組みで、受信ポートは必要ありません。同じ考え方で、社内から送り出す向きの経路を選びます。
「読み取り専用」は、AIの設定ではなくどこで守るか
AIのツール接続で「読み取り専用」と表示されていても、それは振る舞いの保証ではありません。AIを外部のツールやデータにつなぐ公開仕様のMCPでは、readOnlyHint が true なら、そのツールは環境を変更しないことを示すとしています。ただし同じ仕様は、こうした注釈はヒントであり、ツールの振る舞いを正しく表す保証はないと明記しています。
つまり、AIの側で「読むだけ」と宣言しても、基幹のデータが書き換わらない根拠にはなりません。社内で「AIが基幹を書き換えないと言い切れるのか」と聞かれたときに答えになるのは、次の3つの場所です。
| 守る場所 | 具体例 | 確かめること |
|---|---|---|
| DBの読むだけのユーザ・ロール | PostgreSQL の定義済みロール pg_read_all_data は、全テーブルを SELECT 権限があるかのように読める。書き込みの権限は別のロール | 取り込み用のユーザに、書き込みの権限が付いていないか |
| 読み取り専用のレプリカ・待機系 | RDS のリードレプリカは読み取り専用のコピー。PostgreSQL のホットスタンバイは、待機中のサーバーで読み取り専用の問い合わせを実行できる | 接続先が本番ではなく写しになっているか |
| 写しの置き場の権限 | 表計算・業務アプリ・データウェアハウスの側で、AIの接続に閲覧だけの権限を渡す | AIに渡した接続の権限で、写しを消したり書き換えたりできないか |
3つを重ねておくと、どこか1つの設定を誤っても基幹までは届きません。AIのツール側の表示は、この3つを確かめたうえでの目印として使います。
データの置き場は、件数・更新頻度・部署数でどう選ぶか
写しの置き場は、件数が表計算の上限より十分少なく使う部署が1つなら表計算、複数部署が画面で見て入力も伴うなら業務アプリ、件数が多いか更新が1日に何度もあり、複数部署・拠点で突き合わせるならデータウェアハウスです。上限値は各社の公式の値(2026年10月時点)です。「向く条件」の列の目安は、上限値と使い方から私が整理したもので、公式が決めた境目ではありません。
| 置き場 | 公式の上限値(2026年10月時点) | 向く条件(本記事の整理・目安) |
|---|---|---|
| 表計算(Excel・Googleスプレッドシート) | Excel は1シート 1,048,576 行まで。スプレッドシートは1ファイル 2,000万セルまたは 100MB まで | 件数が上限より十分少ない/使う部署が1つ/写しの更新は1日1回程度で足りる |
| 業務アプリ(kintone など) | kintone の REST API はスタンダードコースで1アプリ1日 10,000 リクエストまで。offset で指定できるのは 10,000 件まで。同時リクエストは1ドメイン 100 まで | 複数部署が画面で見て、入力やコメントも伴う/取り込みとAIの読み出しが1日の回数に収まる |
| データウェアハウス(BigQuery・Microsoft Fabric など) | BigQuery は保存が毎月 10GiB まで、クエリは毎月 1TiB まで無料。Fabric のミラーリングは既存のDBから継続的に複製する | 件数が表計算の上限に近い/1日に何度も更新する/複数部署や拠点の数字を突き合わせる |
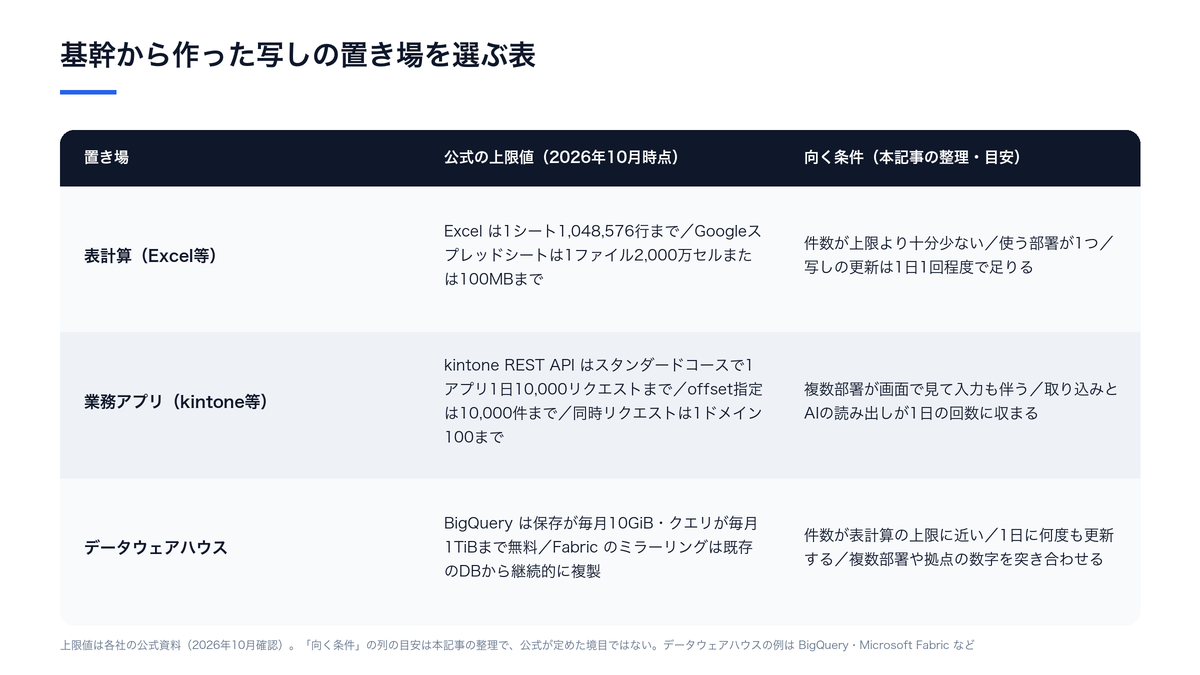
表は、受注・在庫・売上のように基幹にある一般の帳票で使えます。対象のデータごとに、件数・写しを更新したい回数・使う部署の数の3つを数え、3つとも当てはまる行を選びます。行が割れたときは、下の行(より大きい置き場)に寄せます。
業務アプリは、件数より回数の上限が先に効く
kintone を置き場にすると、件数よりAPIの回数の上限が先に問題になります。写しを入れる取り込みと、AIが読みにいく処理は、同じアプリの1日の回数を分け合います。1万件を超えるレコードを offset で順にたどる読み方もできないため、読み方を提供元の仕様で確かめておきます。kintone の中のどのアプリ・どの項目をAIに渡すかは、kintoneとAIの連携の限界と渡し方を整理した記事で扱っています。
更新の頻度は、見る側の回数でも決まる
写しを何回更新できるかは、置き場だけでなく、写しを見る側の仕組みにも上限があります。Power BI の定期更新は、共有容量では1日8回まで、Premium 容量・PPU・Fabric 容量では1日最大48回までです。AIの答えや集計表に出る数字は、最後に更新した時点のものです。AIの答えには、何時点の数字かを添える設計にします。
部署や拠点に散ったデータは、置き場を新しく作るべきか
部署や拠点ごとに散ったデータは、置き場を新しく作るべきか。使う部署が1つなら、その部署がすでに使っている表計算や業務アプリを置き場にします。複数の部署や拠点で同じ数字を見る、または突き合わせるなら、1か所に写しを作ります。
分かれ目は、同じ数字を2か所以上で持つかどうかです。営業部の表計算と経理の業務アプリに同じ受注の写しがあると、どちらが新しいかで答えが割れます。AIに聞いても、どちらの写しを読んだかで答えが変わります。こうした食い違いが出るなら、基幹からの写しは1か所にまとめ、各部署はそこを読む形にします。
経済産業省の総括レポートも、DXの鍵はデータの利活用であり、データを蓄積・処理するシステムが変化に追従できる必要があるとしています。基幹を改修しない場合、その役割を受け持つのが中間の置き場です。部署ごとの転記そのものを無くす話は、二重入力をAIで無くす仕組みをまとめた記事に任せます。
基幹の提供元や保守会社に、何を確かめるか
基幹を触らずに進める前に、提供元や保守会社に確かめるのは次の6項目です。読み出し方が使えるかは、製品名が同じでも版・導入形態・保守契約で変わりえます。名前の知られた基幹製品でも、自社の環境で使えるかは断定せず、この表で確かめます。
| 確かめる項目 | 聞くこと | 答えで決まること |
|---|---|---|
| CSV出力 | 受注・在庫・売上などを書き出す機能があるか。出せる項目と、自動で定時に出せるか | CSV出力で始められるか |
| 読むだけのユーザ | DBに読み取り専用のユーザを作れるか。作ってよいか | 読み取り専用の接続が使えるか |
| レプリカ・待機系 | 待機系やレプリカがあるか。そこに接続してよいか | 本番に負荷をかけずに読めるか |
| 抽出の時間帯と負荷 | 読んでよい時間帯と、避けるべき処理(締め・夜間の処理など) | 写しの更新の頻度 |
| ライセンス上の扱い | 基幹のデータを外部の仕組みから参照・利用するとき、追加の契約が要るか | 費用と契約の前提 |
| 仕様書・項目の定義 | テーブルや項目の意味を書いた資料があるか | 写しの項目をAIに正しく説明できるか |
最後の仕様書の項目は、ブラックボックス化した基幹ほど答えが返りにくい所です。資料が無い場合は、写しの対象を受注・在庫・売上など項目の意味が分かる帳票から始め、AIに渡す項目を絞ります。写しを作って試したあと、本番の運用に移してよいかの条件は、AIのPoCを本番へ移行してよいかの条件をまとめた記事で整理しています。
この記事のまとめ
- 現場がAIに聞きたいことを1つ選び、それに要る基幹の帳票と項目を書き出します。
- その帳票の件数・写しを更新したい回数・使う部署の数を数え、置き場の表で行を1つ選びます。
- 確認の6項目を保守会社に送り、使える読み出し方が分かったら、基幹・読み出し・置き場・AIの4つの箱に自社のシステム名を当てはめて社内に説明します。
公開日:2026年10月
読んで終わりにしないために
「自社の場合は、どうすれば?」
その答えを、最大45分で持ち帰る。
記事で分かるのは、一般論まで。AI導入を専門に見ている担当が、貴社の業務に当てはめて“次の一手”だけを一緒に整理します。
この相談で持ち帰れるもの
- 01
自社業務に当てはめたAI活用マップ
- 02
投資対効果(ROI)のシミュレーション
- 03
いまの悩み・疑問への、その場の個別回答