自社の業務システムをAIで開発したいと考えた会社が最初にぶつかるのは、コードを書く部分ではなくデータベース設計です。「ER図は生成AIに出させて、あとはそのまま流し込めば終わる」——こうした判断で走り出した案件が、実装1ヶ月後にデータの欠損・整合性のずれ・度重なる仕様変更で身動きが取れなくなり、設計をまるごと作り直す流れは珍しくありません。
この記事は「AIで開発したい」と考える会社が最初に読む総論として、データベース設計をAIに任せたときに詰む3つの落とし穴を軸に、AIに任せていい工程と人が責任を持つ工程の切り分け、費用・リスク・評価・内製か外注かの判断まで、AI開発の論点全体を1枚の地図にして整理します。仕様書・バグ整理・コーディング環境といった各論は本文の中から個別の記事へつなぎ、この記事では判断に要る材料を解説します。
- データベース設計を生成AIに丸投げで詰むのは、設計責任の所在が曖昧なまま、業務ヒアリングが3割しか揃わない状態でER図が固まることが原因
- AIに任せていい工程はER図ドラフト・命名候補・正規化チェック・サンプルSQLの4つ。人が責任を持つ工程は業務ヒアリング・将来予測・運用責任・規制対応の4つ。AI開発全体でも「材料を揃える・最終判断・運用責任」は人に残る
- 詰む3つの落とし穴は、業務ヒアリング不足・将来変更未反映・責任者未指名。レビュー・運用・データ監査の3名を明示する。費用は人月ではなく「消える作業」の単位で、評価は手戻り件数と設計変更回数を自社で測る
AIで開発するとは何か?中小企業が先に見る7つの論点の地図
AIで開発するとは、要件の聞き取りから設計・実装・テスト・運用までの工程のうち、材料がそろっていて答えの形が決まっている作業を生成AIに渡し、材料を揃える工程と最終判断と運用責任を人が持つ進め方のことです。コードを書く速さだけを買う話ではなく、どの工程を誰が持つかを決め直す話だと言い換えられます。開発の道具も変わりました。Anthropicの公式ドキュメントでは、Claude Codeはコードベースを読み、ファイルを編集し、コマンドを実行する「エージェント型のコーディングツール」と説明されています。道具がここまで進んだ分、人が持つ工程の線引きが結果を決めます。
「AIで開発したい」と考える会社の問いは、だいたい7つに分かれます。先に短い答えを並べておきます。この記事の本文で扱うのは、設計の入口であるデータベース設計を題材にした「設計」「リスク」「評価」の3つで、残りは各論の記事に任せています。
| 論点 | 会社が決めること | 先に出しておく答え |
|---|---|---|
| 基本 | AIは開発の何を代わるのか | 代わるのはドラフトと候補出しと機械的なチェックの3つ。要件の聞き取り・最終判断・運用責任は代わらない。本記事の第3節で工程ごとに切り分ける |
| 設計 | 設計書をAIにどこまで書かせるか | ER図とAPI仕様はドラフトまで。人が業務の実態と将来の変更を足して確定する。API仕様の進め方と稟議の通し方はAPI設計書をAIで作って稟議を通す進め方で扱っている |
| 実装 | どの環境でコードを書かせるか | 社内の開発環境にエージェント型のツールを置き、設計書と命名規則を読ませてから書かせる。環境の整え方は担当サービス(第7節)で触れる |
| 費用 | いくらまでなら払ってよいか | 人月単価ではなく「消える作業」の単位で置く。手戻り1件に要していた時間×月の件数(例:3時間×6件=月18時間)が、設計にかける費用の上限になる |
| リスク | 何が起きると取り返しがつかないか | 本番データの欠損と整合性破綻。設計責任者・運用責任者・データ監査責任者の3名を、ER図確定の前に書面で決める。第4節の落とし穴3で扱う |
| 評価 | うまくいっているかをどう測るか | 実装中の仕様変更件数(週あたり)、手戻り1件あたりの時間、運用後3ヶ月のデータ不整合の件数の3つを自社で測る。テスト工程のバグの整理はバグ報告をAIで整理するときの5つの限界で分けている |
| 意思決定 | 内製で進めるか、外の手を入れるか | 設計責任者を社内に置けるなら内製。置けないなら、設計レビューと環境構築だけ外に出し、実装は社内に残す。第7節で境目を示す |
7つの論点に順番はあるか
順番はあります。7つのうち実装(どのツールでコードを書かせるか)から入ると、設計の穴がそのままコードに固まり、第4節で書く手戻りが毎週走ります。基本と設計で工程の線を引き、リスクの3名を決め、評価の数字(仕様変更件数・手戻り時間)を測る準備をしてから、実装の環境を整える。費用の上限はその数字から逆算できるので、最後で足ります。意思決定は、設計責任者を社内に置けるかどうかの1点で決まります。
人間の判断を介在させる、という前提
AI事業者ガイドライン(第1.2版)は、AIに単独で判断させるのではなく、適切なタイミングで人間の判断を介在させる利用を検討するよう求めています。開発に当てはめると、ER図やコードの「出力」ではなく、それを採用する「判断」を人が持つということです。この前提を置くと、第3節で挙げる「AIに任せる4工程・人が持つ4工程」の線は自然に引けます。
なぜ中小企業のDB設計はAI丸投げで詰むのか
中小企業の業務システム案件では、DB設計に十分な工数を割けないまま、生成AIに「業務をヒアリングしてER図を出して」と頼むケースが目立ち始めています。背景には、専任のデータベース設計者がいない・要件定義がきれいに書面化されていない・社内に過去設計の知見が文書として残っていない、という3つの構造課題があります。AIは入力された情報の範囲でしか設計できないため、入力が雑なら出力も雑になる、というシンプルな構造です。
私はBoostXでAI顧問として、生成AIの導入と業務の自動化を一気通貫で支援しています。その中で見える、データベース設計を生成AIに任せようとして詰む形には共通点があります。発注側がAIを「優秀な設計者」と認識してしまい、設計責任を曖昧にしたままER図を信用し、実装が走り出してから取り返しがつかなくなる、という流れです。2025年度の企業向け調査では、生成AIを積極的に活用する方針か領域を限定して利用する方針の企業は中小企業で58.1%まで増えています。方針を持つ会社が増えた分、「どこまで任せるか」を決めずに開発へ使う会社も増えています。
「設計責任の所在」が曖昧になることが詰みの入口
DB設計AIが出した結果に対して、誰がレビューして・誰がGOサインを出して・誰が後で責任を取るのか、を最初に決めていない案件は高い確率で詰みます。AIは責任を取れないので、人間側にレビュー責任者が必要です。中小企業では「とりあえずエンジニアに見せた」「とりあえず社長が見た」レベルで止まり、設計責任が誰にもない状態でテーブルが走り出すケースが少なくありません。1〜2名規模のシステム担当者しかいない中小企業ほど、この役割分担の曖昧さが運用3〜6ヶ月後にデータ整合性のずれとして表面化します。
設計責任の所在が決まっていない案件では、リリース後3ヶ月〜6ヶ月の間に「このカラム値どっちが正?」「このマスタは誰が更新する?」という問いが社内で1日に1〜2回発生します。聞かれた側はAIが出した設計を理由に答えられず、データの矛盾が積み上がり、半年後に「データが信頼できない」状態に陥ります。設計責任者1名・運用責任者1名・データ監査責任者1名の3名を、ER図確定の前に書面で決めておくこと。これだけで運用後の詰みリスクが大きく下がります。
業務理解が一次情報として揃っていないままER図を出している
DB設計の前段にあるべき業務フロー・データの発生源・更新タイミング・正規化の判断材料が、一次情報として揃わないまま「AIに聞けば」と進む現場があります。これはAIの問題ではなく、入力データの問題です。生成AIに渡せる業務情報が3割しかなければ、出てくるER図の精度も3割を超えません。「AIは優秀な検索係であって、設計の責任者ではない」「ゴミを入れればゴミが出る」という原則が、DB設計でも同じ構造で効いてきます。
業務情報の一次インプットが不足するとどうなるか。典型的には、ER図のテーブル数は20〜30個と十分に見えるのに、実装3ヶ月後に「現場で発生している伝票が漏れていた」「1日あたり50〜100件流れる業務イベントが想定外だった」「月末月初の集中処理で1日2000件のレコードが入る」などの後出し情報で、テーブル設計の見直しが2〜3回入ります。手戻り1回あたりの実装工数の増え方は案件で違うので、自社の直近の案件で「設計変更1回に何時間かかったか」を1案件・3回分だけ先に測っておくこと。AIに渡す前に、業務担当者3〜5名に対する10〜20時間のヒアリングと、業務イベントの発生件数の概算を必ず手元に揃えておくこと。
データベース設計AIで本当にできることの範囲
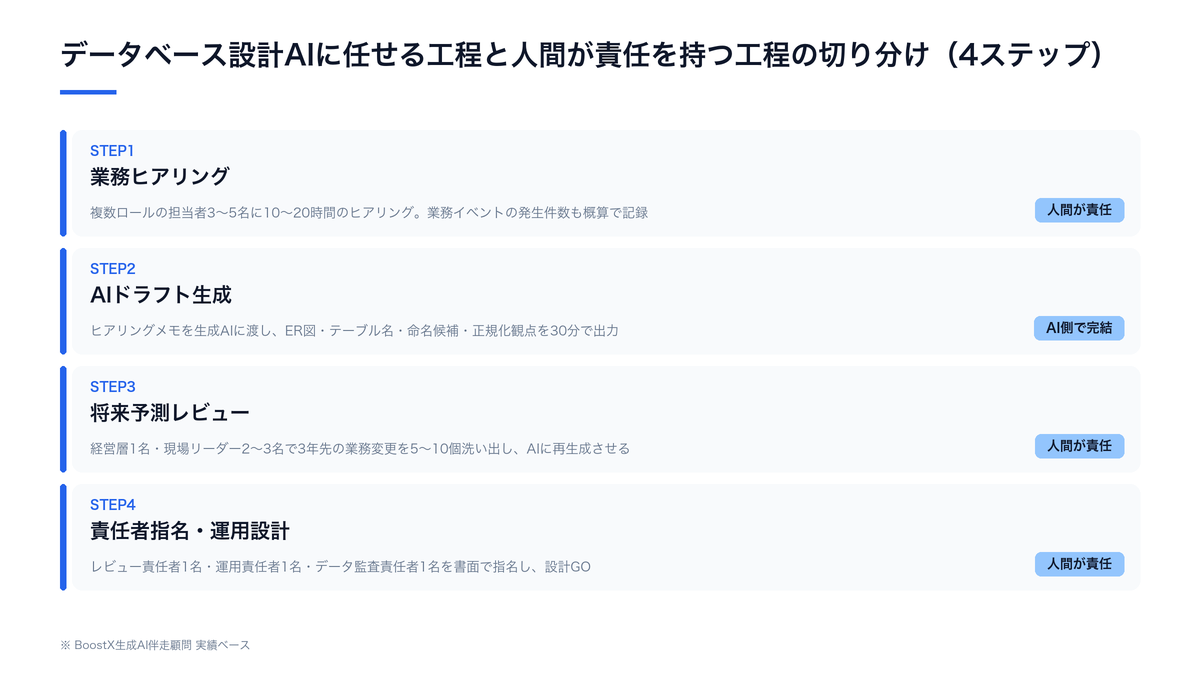
データベース設計AIに任せられる範囲を、現実的なラインで切り直します。結論を先に言えば、ER図のドラフト・テーブル名と命名の候補出し・正規化観点のチェック・サンプルSQLの生成までは、生成AIに任せる価値が十分あります。一方で、業務要件のヒアリング・データの実発生現場の観察・将来の業務変更を見越した設計判断・本番運用での保守責任は、人間側に残さなきゃいけません。
この領域でつまずきやすいのは、ツール選定よりも「開発の工程のどこに組み込むか」の設計です。同じ切り分けは、ER図に限らずAPI仕様書やバッチ処理の設計にも当てはまります。
AI側に寄せていい4つの工程
第一に、業務ヒアリングメモから一次案のER図と主要テーブルのカラム候補を出すドラフト工程は、生成AIが最も得意な領域です。30分かけて手で書く設計書ドラフトが10分でたたき台になります。第二に、テーブル名・カラム名・命名規則の統一は、AIが過去の命名規約を踏まえて候補を5案出すのが速く、人間は選ぶだけで済みます。第三に、第3正規形までの正規化観点で「ここは別テーブルに切り出せる」「ここは冗長な気がする」というレビュー視点の提示は、AIの方が網羅性で勝ります。第四に、サンプルSQL・サンプルマイグレーションの叩き台生成も、AI側で十分です。AIが受け取るものはヒアリングメモと命名規約、返すものはドラフトと候補と指摘、人が確認することは「業務の実態と合っているか」の1点です。
人間側に残さなきゃいけない4つの工程
第一に、業務の実発生現場を見て「この入力は本当に1日に何件発生するのか」「この項目は将来も使うのか」「ここは別ロールが触るのか」を、肌感覚で判断する工程は人間にしか務まりません。第二に、将来の業務変更を見越した設計判断、たとえば「3年後にこの業務が分社化されるかも」「来期から多拠点運用になる」といったビジネス文脈は、AIの学習データには含まれません。第三に、運用フェーズで誰がメンテし・誰がデータ品質を担保し・誰が監査を受けるかを決める設計責任は、当然AIには取れません。第四に、セキュリティ要件・個人情報保護法・業界規制対応の最終判断は、人間が責任を持って下す領域です。人が残す判断はこの4つで、理由はいずれも法令・契約・運用責任が自社に帰ってくるからです。
ER図だけでなく、仕様書とテストにも同じ線が引ける
API仕様書なら、エンドポイントの一覧とリクエスト・レスポンスの型のドラフトはAI側、認証方式と外部公開の範囲と稟議の説明は人側です。テスト工程なら、バグ報告の分類と重複の束ねはAI側、修正の優先順位と出荷の判断は人側です。工程が変わっても「ドラフトと候補はAI、実態の確認と最終判断は人」という線は同じ形で引けます。
中小企業のDB案件で詰む3つの落とし穴
ここからは、生成AIにDB設計を任せて詰む中小企業案件で繰り返し見られる3つの落とし穴と、それぞれの構造的な原因を整理します。どれも「AIが弱い」のではなく、「AIへの入力情報と運用責任の設計が甘い」ことが本質です。
落とし穴1:業務ヒアリングを省いて出力されたER図をそのまま採用してしまう
最も多いのが、現場の業務ヒアリングを2〜3時間しか取らず、生成AIに「だいたいこんな業務です」と要約を渡してER図を出させ、そのまま実装に進む流れです。実装が3割進んだ段階で「現場の伝票はこっちも紐づいていた」「この項目は別部署も更新する」「この日時はタイムゾーンが2種類ある」といった抜けが露呈し、テーブル設計を作り直す羽目になります。業務ヒアリングは、AIが代行できない人間の責任工程です。1案件で最低でも10〜20時間はかけて、複数ロールの担当者の手元を見せてもらう必要があります。
業務ヒアリングを後工程に回すと何が起きるか。実装フェーズで毎週1〜2件の仕様変更が走り、4週間で5〜8件の手戻りが積み上がります。1件の手戻りでテーブル変更・マイグレーション・テストデータ作り直しに2〜4時間かかるため、月で見ると20〜30時間が無駄工数として消えます。これはAIが悪いのではなく、AIに渡すべき業務情報の解像度が低いまま走り出した運用設計の問題です。AI導入の前に、業務ヒアリングの工数を当初の3〜5倍に確保するのが現実的な判断になります。
落とし穴2:将来の業務変更が反映されないまま固まる
生成AIは現時点の業務情報からER図を出すため、「来期から多拠点になる」「3年後に分社化が予定されている」「将来は外部取引先もこのデータを参照する」といったビジネスの先読みが反映されません。中小企業ほど、組織変更・事業分割・外部連携の発生頻度が高く、3年先までを見据えた設計判断が必要です。AIが出したER図に対して、経営者と現場リーダーが将来の業務変更を5〜10個書き出し、設計に反映するレビューを必ず挟むこと。これだけで詰む確率が大きく下がります。
将来予測のレビューは、社内の経営層1名・現場リーダー2〜3名で1〜2時間の議論を持つだけで、十分な精度になります。論点は、3年以内に発生しうる組織変更・拠点追加・取引先連携・外部システム接続・データ保管要件の変化の5項目です。それぞれに対して「発生確率はどれくらいか」「発生した場合DB設計のどこに影響するか」を1行ずつメモすれば、ER図に組み込むべき柔軟性が見えてきます。AIに渡し直すと、その柔軟性を盛り込んだ第2案が10〜15分で返ってくるため、人間の判断時間は短く・かつ精度の高いレビューが可能になります。
落とし穴3:レビュー責任者と運用責任者が決まっていない
生成AIが出したER図に対して、誰が最終GOを出すのか・誰が運用後にデータ品質を保つのかが決まっていない案件は、運用に入ってから揉めます。中小企業では役割が兼務になりがちで、「誰となく」設計が固まり、本番運用後に「これ誰が決めたの」状態に陥ります。最低でも、レビュー責任者1名・運用責任者1名・データ監査責任者1名の3名を明示しておくこと。生成AIの利点は速度ですが、責任の所在は人間側で構造化しておく必要があります。
3名の責任者を立てるとき、兼務はリスクです。レビュー責任者と運用責任者を同一人物にすると、設計時の判断と運用時の負荷判断が同じ目線になり、設計時に「あとで楽だから」を理由に重要な制約を緩めてしまうケースが頻発します。データ監査責任者は経理や情報セキュリティ管理者など、システム部門外の第三者を当てるのが基本です。3名体制が組めない規模なら、外部のAI顧問や設計レビュアーを1名挟むのが現実的な代替案になります。月1〜2回・1回30〜60分のレビュー会を3ヶ月続けるだけでも、運用後3〜6ヶ月のデータ品質劣化は大きく抑えられます。
落とし穴の外にあるリスク:入力する情報と出力の検証
3つの落とし穴は設計の話ですが、もう1つ別の軸があります。IPAの「情報セキュリティ10大脅威 2026」では、組織向けの3位に「AIの利用をめぐるサイバーリスク」が初めて入りました。開発で言えば、本番データや顧客情報をそのままAIに貼り付けてER図を出させる、AIが書いたSQLを検証せずに本番へ流す、という2つがこれに当たります。設計に使う材料は匿名化したサンプルに限り、AIの出力は必ずテスト環境で動かしてから採用する。この2行を、3名の責任者を決めるのと同じ紙に書いておきます。
AI+人の役割分担で得られる効果と作業時間の変化
データベース設計を「AIに丸投げ」ではなく「AI+人の役割分担」で進めると、中小企業の現場でも作業時間と品質の両面で変化が出ます。ただし、どれだけ縮むかは案件の定型率で大きく変わるので、ここに挙げる時間は一般的な目安として読み、自社の直近案件の実測に置き換えてください。
ER図ドラフトと命名候補の生成は工数1/3〜1/5
手書きでER図ドラフトを書き起こすと、業務ヒアリングメモから一次案を出すまでに3〜5時間かかります。生成AIに業務メモを渡してドラフトを出させると、同じ作業が30分〜1時間程度に圧縮できます。命名候補の出し直し・正規化観点での再レビューも、AI側で5分以内にやり直せるため、人間は「どの案にGOするか」の判断に集中できます。
ヒアリングと将来予測の時間を増やせる
ドラフト作成の時間が圧縮されると、人間側は本来時間をかけるべき業務ヒアリング・将来の業務変更の洗い出し・運用フローの設計に時間を振り分けられます。AIに渡せるドラフト作業を圧縮し、人間が責任を持つべき業務ヒアリングと先読みに工数を再配分するのが、効果の本筋です。縮めた時間を別の実装に回すのではなく、ヒアリングに回した案件ほど、実装後の仕様変更が減ります。
残業の原因は「人がやらなくていい仕事を人がやっていること」
私の考えでは、IT・業務開発まわりの残業の多くは、「人がやらなくていい仕事を人がやっている」状態から発生しています。ER図のドラフト・命名候補の作成・正規化の機械チェック・サンプルSQLの叩き台は、まさに「人がやらなくていい仕事」の典型です。AIに任せられる工程を見極めて、人間は判断と責任のある工程に集中する。この再設計が、結果として残業時間と設計品質を同時に改善します。
効果の測り方は「仕様変更件数」と「手戻り1件の時間」
効いているかどうかは、ドラフトが何分で出たかではなく、実装中の仕様変更件数と手戻り1件あたりの時間、運用後3ヶ月のデータ不整合の件数で見ます。着手前に直近案件のこの3つを数えておき、AI+人で進めた案件と比べます。費用の上限もここから逆算できます。手戻り1件に平均3時間かかっていて月6件起きているなら、月18時間分の人件費が、設計レビューにかけてよい費用の目安です。
ビフォーアフター:DB設計プロジェクトがここまで変わる
現状の苦しい1案件
業務ヒアリングは2〜3時間で打ち切られ、要件定義書は箇条書きで3ページ。設計者は片手間で、ER図のドラフト作成に1週間。実装に入ってから「この項目が抜けていた」「この紐付けが違う」と毎週仕様変更が走る。テスト工程でデータ不整合が3〜5件見つかり、リリースが2週間ずれる。リリース後も運用責任者が決まっておらず、データ品質が徐々に劣化し、半年後にはマスタデータが信頼できない状態に陥る。当初見積もりを大きく超える工数がかかり、関係者全員が疲弊する——これが、AI不在のままでもAI丸投げでも起きる「Before」のリアルです。
AI+人の役割分担で進む1案件
業務ヒアリングに10〜20時間をかけ、複数ロールの担当者の手元と発生データを直接観察する。要件メモを生成AIに渡してER図ドラフトを30分で出させる。経営者と現場リーダーが将来の業務変更を5〜10個洗い出し、AIに再生成させて2案を比較する。レビュー責任者・運用責任者・データ監査責任者の3名を明示し、設計GOを出す。実装中の仕様変更は当初の半分以下に収まり、テスト工程でのデータ不整合はほぼゼロ。リリース後はデータ品質が3ヶ月、6ヶ月、1年と劣化せず、社内の業務改善ループが回り続ける——これが、AI+人の役割分担で進む「After」の姿です。
違いを生んでいるのはツールではなく運用設計
BeforeとAfterの違いを生んでいるのは、生成AIの性能ではなく、人間側の運用設計です。誰が責任を持ち・どこまでAIに任せ・どこから人間が判断するかの線引きが、結果として品質と工数の両方を決めています。同じ線引きは、ER図の次に来るAPI仕様書・実装・テストの各工程でもそのまま使えます。
社内だけでAI開発を進めると、どこで止まるのか
ここまでの切り分けは、設計責任者を社内に置ける会社なら自力で回せます。止まりやすいのは2か所です。1つは、設計責任者・運用責任者・データ監査責任者の3名が社内で揃わず、兼務のまま走り出すとき。もう1つは、AIにコードを書かせる環境そのもの——設計書や命名規則を読ませる場所、本番へ流す前に動かすテスト環境、入力してよい情報の範囲——が整っておらず、担当者がそれぞれ個人の環境で試しているときです。前者は設計の穴として、後者は品質と情報の持ち出しの穴として、3〜6ヶ月後に表面化します。
自社で回せているかを測る3つの項目
ER図確定前に3名の責任者が書面にある、実装中の仕様変更件数を数えている、AIが書いたコードは必ずテスト環境を通ってから本番に入る。この3つが成り立っていれば、社内で回せています。3名が揃わない、仕様変更を数えていない、個人の環境で書いたコードが直接本番に入っている、のどれかに当てはまるなら、設計レビューと環境の整備だけを外に出す段階です。
外に出すなら、設計レビューと開発環境の整備だけ
実装を丸ごと外注すると、業務の実態を知っている人が設計から離れ、第4節の落とし穴1に戻ります。外に出す範囲は、設計レビューの第三者と、社内でAIにコードを書かせる環境の整備に絞るのが実務的です。BoostXのClaude Code構築支援は、社内の開発環境にClaude Codeを置き、設計書・命名規則・入力してよい情報の範囲を読ませた状態で社内の担当者が書き始められるようにするところまでを担当範囲にしています。実装の主役は社内の担当者で、外に出すのは環境と設計の目です。決めきれない点を1つ挙げるなら、「データ監査責任者を社内の経理に置くか、外部に置くか」です。経理が会計システムのデータ構造を把握している会社なら社内で足りますし、把握していなければ外部のレビュアーを当てたほうが、運用後の不整合は早く見つかります。
この記事のまとめ
- 着手前に決めるのは、設計責任者・運用責任者・データ監査責任者の3名を紙に書くことと、業務担当者3〜5名への10〜20時間のヒアリング枠を先に押さえること。ER図をAIに出させるのはその後
- AIの出力は採用の判断ではなく材料。ER図でもAPI仕様でもコードでも、「ドラフトと候補はAI、実態の確認と最終判断は人」の線を工程ごとに同じ形で引く
- 効いているかは、実装中の仕様変更件数・手戻り1件の時間・運用後3ヶ月の不整合件数の3つを自社で数えて判断する。費用の上限はこの数字から逆算する
- 外に出すのは設計レビューの第三者と、社内でAIにコードを書かせる環境の整備まで。実装を丸ごと外に出すと、業務を知る人が設計から離れて落とし穴1に戻る
公開日:2026年6月
読んで終わりにしないために
「自社の場合は、どうすれば?」
その答えを、最大45分で持ち帰る。
記事で分かるのは、一般論まで。AI導入を専門に見ている担当が、貴社の業務に当てはめて“次の一手”だけを一緒に整理します。
この相談で持ち帰れるもの
- 01
自社業務に当てはめたAI活用マップ
- 02
投資対効果(ROI)のシミュレーション
- 03
いまの悩み・疑問への、その場の個別回答