月に5本のブログを出しているのに検索順位は動かず、AI検索の回答欄には競合の名前だけが並ぶ。担当者の実感としては「書いても書いても、AIに要約されて終わっている」という一言に尽きます。並べて読み比べると、自社の記事も競合の記事も『生成AIのメリット5選』『導入で押さえるポイント3つ』と、構成も主張もほとんど同じ。書いた本人は1本に数時間をかけているのに、読者はAIの要約で用が足りてしまい、記事までたどり着かない。AIOやAI検索を意識して記事を出している会社では、この状態が定番になっています。
先に結論をお伝えします。AIに引用される記事と、AIに要約されて終わる記事の境目は、一次情報(自社でしか持っていないデータ・事実・知見)が本文に入っているかどうかです。Googleは、AIを使ったこと自体はランキングの有利にも不利にもならず、評価するのは有用でオリジナルなコンテンツかどうかだと公式に示しています。本記事では、記事1本あたりの調査・執筆に平均6時間、月5本で30時間という前提を置いて話を進めます(公的統計ではなく本記事の目安です。自社の実績値に置き換えてお読みください)。その30時間がAIに要約されて終わる構造、一次情報と二次情報の比較表、社内に眠る5つのデータ資産、自前で出し続けたときに止まる場所までを、手順書ではなく判断の材料として整理します。
AI検索全体の考え方を先に押さえたい方は、GEO・AIO・LLMOの違いとAI時代のSEOで用語と全体像を確認してから、この記事に戻ると一次情報の位置づけが分かりやすくなります。
- AIに引用されるかどうかは、一次情報が本文にあるかで分かれる。Googleは「AIを使用したからといってランキングに関して特別なメリットがあるわけではない」と明示し、独自の情報・分析を提示しているかを自己評価の問いに置いている(Google 検索セントラル、2023年2月公表・2026年9月確認)
- 日本企業の55.2%が何らかの業務で生成AIを使い、用途の中心は「メールや議事録、資料作成等の補助」47.3%。中小企業の活用事例は「メール・報告書・議事録の作成・要約」74.0%で、リサーチは20.2%(総務省 令和7年版 情報通信白書・商工中金 2026年1月調査)。同じAIに同じ公開情報を要約させる使い方が主流のため、出力が似るのは構造的
- 記事1本6時間・月5本=月30時間という前提を置くと、二次情報だけの記事はこの30時間がまるごとAIの要約に吸われる。月5本を3本に減らし、うち1本を自社データ入りに置き換えると、本記事の目安では月22時間で引用されうる記事が月1本残る
AIOで1次情報の有無が境目になる:AI生成コンテンツの「均質化問題」
均質化問題とは、同じ生成AIが同じ学習データから記事を作る以上、誰が書いても構成と主張が似通い、検索結果の1ページ目に「同じ内容の記事」が並ぶ状態のことです。AIOやAI検索の回答は、その中から1つか2つを引用して要約を作ります。引用されるのは、AIがすでに持っている一般論ではなく、そのページにしか無い情報を含む記事です。ここで境目になるのが1次情報の有無です。
なぜAIが書く記事はどれも同じになるのか
ChatGPTやGeminiに『生成AIの導入メリットを5つ』と指示すれば、誰が指示しても似た構成の記事が返ってきます。学習データが同じで、指示も同じだからです。問題は、その使い方が主流になっている点にあります。総務省「令和7年版 情報通信白書」(令和7年版、2026年9月確認)によれば、日本では何らかの業務で生成AIを利用している企業が55.2%で、用途の中心は「メールや議事録、資料作成等の補助」の47.3%です。
中小企業に絞るとこの傾向はさらに強く、商工中金「中小企業の生成AIの利用にかかる調査(2026年1月調査)」(2026年3月公表、2026年9月確認)では、活用事例の最多が「メール・報告書・議事録の作成・要約」の74.0%、「デスクワーク作業支援・自動化」が48.7%で、「リサーチ」は20.2%にとどまります。作成と要約に使う会社が4社に3社、リサーチに使う会社は5社に1社という配分です。この数字から読めるのは、公開されている情報をAIに要約させて文章を作る使い方が主流で、自社だけのデータを集めて分析する使い方はまだ少数派だという構造です。同じ材料を同じ道具で調理すれば、同じ料理になります。
AIOで引用されるかどうかは、1次情報の有無で分かれる
Googleは、AIで書いたかどうかを評価の基準にしていません。Google 検索セントラル ブログ「AI 生成コンテンツに関する Google 検索のガイダンス」(2023年2月公表、2026年9月確認)は、「AI を使用したからといってランキングに関して特別なメリットがあるわけではありません。有用、有益なオリジナル コンテンツで、E-E-A-T の基準を満たすものは、検索で上位に表示される可能性が高くなります」と明示しています。同時に、「検索結果のランキング操作を主な目的として、コンテンツ生成に自動化(AI を含む)を利用することは、スパムに関する Google のポリシーに違反します」とも書かれています。AIで量産すること自体ではなく、量産した結果がオリジナルかどうかが問われる、という線引きです。
E-E-A-Tは専門性・エクスペリエンス(経験)・権威性・信頼性の4つで、Googleはコンテンツを「誰が、どのように、なぜ」の観点から評価するガイダンスを示しています。このうち「経験」は、実際に見た・使った・集めたという事実がなければ書けません。AI検索の側から見ても同じで、AIはすでに一般的な情報を大量に持っているため、わざわざ外部の記事を引用するのは、そこにAI自身が持っていない情報があるときだけです。こうしたAI検索エンジンの選び方は、PerplexityやSearchGPTなどのAI検索エンジンへの対策でも触れています。どこにでもある情報を並べただけの記事は、要約の材料にはなっても、引用元には選ばれません。
AIに要約されて終わる記事に、月30時間が流れる(本記事の目安)
冒頭で置いた前提をここで計算します。記事1本あたりの調査・執筆に平均6時間、月5本で30時間、年間で360時間です。この30時間で作った記事が二次情報(他サイトや公開レポートのまとめ直し)だけで構成されていると、AIはその記事を要約の材料として使い、読者はAIの回答で用を足します。記事は読まれず、引用もされず、30時間分の成果は表示回数の数字として残るだけです。公的統計に「AIに要約されて失う時間」という項目は存在しないため、この30時間はあくまで本記事が置いた前提です。ただ、1本あたりの時間と月の本数を自社の数字に置き換えれば、同じ構造の計算がそのまま成り立ちます。
一次情報とは何か?AIが要約できるデータと書けないデータはどこで分かれるのか?
一次情報とは、自社の現場・顧客・実験から直接得られ、他のどこにも公開されていないデータ・事実・知見のことです。ネット検索では手に入らず、生成AIが学習データから作り出すこともできません。二次情報は、誰かが発信した情報をまとめ直したもので、ニュースの引用、公開データの再編集、書籍の要約が該当します。AIが得意なのは後者で、前者は人が集めるしかありません。
一次情報と二次情報の決定的な差
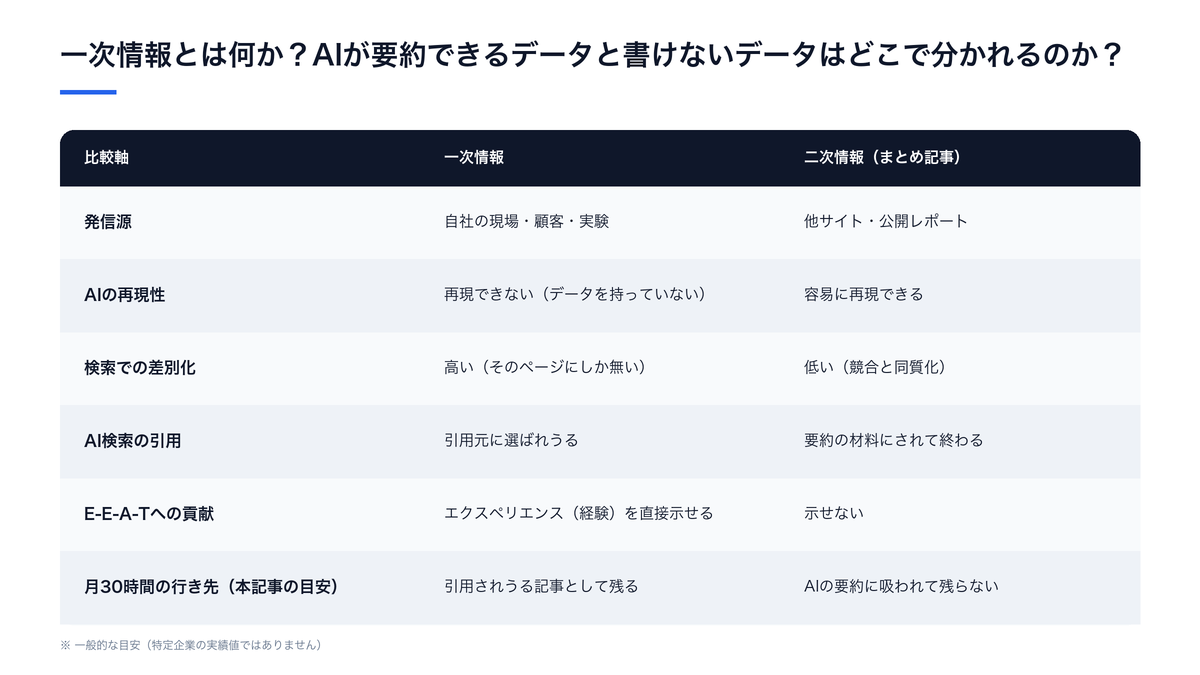
両者の差を5つの軸で並べます。表の右側に書いたものだけで記事を作ると、AIが同じことをより速くできるため、読者にも検索エンジンにも「この記事でなければならない理由」が残りません。
| 比較軸 | 一次情報 | 二次情報(まとめ記事) |
|---|---|---|
| 発信源 | 自社の現場・顧客・実験 | 他サイト・公開レポート |
| AIの再現性 | 再現できない(データを持っていない) | 容易に再現できる |
| 検索での差別化 | 高い(そのページにしか無い) | 低い(競合と同質化) |
| AI検索の引用 | 引用元に選ばれうる | 要約の材料にされて終わる |
| E-E-A-Tへの貢献 | エクスペリエンス(経験)を直接示せる | 示せない |
| 月30時間の行き先(本記事の目安) | 引用されうる記事として残る | AIの要約に吸われて残らない |
AIは自社データの変化を要約できるのか?
AIは私のデータの変化を要約できますかという疑問を持つ方は少なくありません。答えは、要約はできますが、データそのものはAIには作れません、です。月別の問い合わせ件数、アンケートの回答、商談メモをAIに渡せば、前月との差や傾向の変化を文章にまとめることは得意です。ただし、そのデータを持っているのは自社だけで、AIの学習データには入っていません。つまり「自社データの変化をAIに要約させた結果」は、それ自体が一次情報になります。二次情報の記事を書くときにAIを使うと均質化しますが、自社データの整理にAIを使うと差別化の材料が生まれる、という対照的な関係です。
注意点が1つあります。要約させるために顧客の氏名や連絡先を含む生データをそのまま入力するのは避け、集計済みの数字か匿名化した文章に整えてから渡すことです。この線引きは第3章で扱います。
Googleが自己評価に置いている4つの問い
一次情報が必要だと言えるのは、Google自身が公開しているコンテンツの自己評価に、それを問う項目があるからです。Google 検索セントラル「有用で信頼性の高い、ユーザーを第一に考えたコンテンツの作成」(Google 検索セントラル ドキュメント、2026年9月確認)には、次の問いが並んでいます。
| Googleの自己評価の問い(原文の趣旨) | 二次情報だけの記事 | 一次情報を含む記事 |
|---|---|---|
| コンテンツは、独自の情報、レポート、研究または分析の結果を提示しているか | 提示していない | 自社データの集計・分析で提示できる |
| 他のソースを参考にした場合、単なるコピーや書き換えではなく、付加価値とオリジナリティを十分に示しているか | 書き換えにとどまりやすい | 公開データに自社の数字を重ねて付加価値を示せる |
| 実体験や深い知識(実際に商品やサービスを使用した経験など)を明確に示しているか | 示せない | 自社での実験・顧客の声で示せる |
| 検索結果に表示された他のページと比較した場合、実質的な価値を提供しているか | 他ページと同質 | そのページにしか無い情報がある |
4つの問いは、いずれも「そのページにしか無いものがあるか」を別の角度から聞いています。二次情報だけの記事は4つとも「いいえ」になり、一次情報を1つ入れるだけで4つとも「はい」に変わります。
取り組みやすい一次情報の5つの型
一次情報と聞くと大規模な調査を想像しがちですが、規模の小さい会社がすぐ着手できるのは次の5つです。共通するのは、すでに社内で起きていることを、期間・対象・数字を添えて外に出すという点です。
1. 顧客アンケート
既存顧客への短い設問。無料のフォームで10問前後、30件ほど集まれば、傾向を語れる材料になります。「導入前に不安だったこと」「実際に使って変わった点」のような設問は、回答そのものが他社に無い文章です。
2. 事例インタビュー
顧客に30分ほど時間をもらい、経緯と結果を聞きます。匿名でも構いません。要点は、所要時間や件数が「何から何に変わったか」を期間と対象を添えて数字で残すことで、この形の文はAIには作れません。
3. 自社での実験レポート
ChatGPTとGeminiで同じ作業をやってみた比較のように、自社で試して結果を公開します。他社の比較記事は仕様の並べ替えになりがちですが、実際に使った結果には、うまくいかなかった点まで含めた具体性があります。
4. 社内データの分析結果
問い合わせの傾向、売上の推移、顧客属性の変化。「いつからいつまで」「何件が何件に」「何と比べて」の3つが揃った文は、その会社にしか書けません。地域密着型のビジネスでは、ローカルSEOとAI検索の両面で、地域固有のデータの価値がさらに高まります。
5. 社員の専門知見
ベテラン社員が当たり前だと思っている知識は、外から見れば希少です。「この業界でつまずきやすい点」「よくある誤解」を記事にするだけで、経験に裏付けられた文章になります。
自社に眠る5つのデータ資産を発掘する
「うちにはデータがない」という感覚は、データを「分析用に整った表」だと思っているときに生まれます。営業日報、問い合わせ履歴、顧客アンケート、業務ログ、社員の暗黙知。どれも整っていないだけで、すでに社内にあります。発掘とは、これらを「コンテンツの素材」として見る視点を持つことです。
「うちにはデータがない」は思い込み
データ活用と聞くとBIツールや専門人材が必要だと構えてしまいますが、記事の素材にするデータは、そこまで大げさなものではありません。次の5つは、ほとんどの会社で特別なツールなしに手が届きます。
| データ資産 | ある場所 | コンテンツ化の切り口 |
|---|---|---|
| 営業日報 | SFA・Excel・チャット | 商談で実際に聞かれた質問の上位10件 |
| 問い合わせ履歴 | メール・フォーム | 実際の問い合わせから作るFAQ |
| 顧客アンケート | 無料フォーム等 | 顧客の回答をまとめたレポート |
| 業務ログ | 勤怠・タスク管理ツール | 所要時間の前後比較 |
| 社員の暗黙知 | ベテラン社員の頭の中 | 現場の判断を言葉にした連載 |
5つに共通するのは、日々の仕事の副産物として自然に貯まっている点です。新しく集める必要がなく、切り口を決めて整えるだけで、第2章の「Googleの4つの問い」に「はい」と答えられる材料になります。
公開してよいデータと守るデータの線引き
「データを公開したら競合に真似されるのではないか」という心配は自然です。線引きは、全体の傾向は出す、個別の詳細は守る、の2つで足ります。問い合わせの内訳の割合や、所要時間の前後比較のような傾向値は、公開しても競争力を損ないません。むしろ「この会社は自社のデータを持っている」という信頼につながります。一方、個別の顧客名、契約条件、価格の内訳、詳細な顧客リストは非公開にします。この2つを分けておけば、公開のリスクは限られた範囲に収まります。
個人情報と顧客の許諾は、書く前に決める
顧客データを扱う記事では、匿名化と集計化を先に済ませ、個社が特定できない形にしてから公開するのが基本です。事例インタビューのように特定の顧客が分かる内容は、事前に許諾を取り、確認してもらった文面だけを出します。この2つは記事を書いた後に直そうとすると、書き直しと再確認で時間が倍になるため、素材を選ぶ段階で決めておくほうが早く進みます。
一次情報をAI検索に引用されるコンテンツに変える4つの条件
一次情報を「持っている」だけでは引用されません。生データをそのまま載せても、人は読まず、AIも抜き出せないからです。引用される形に変わる条件は4つで、問いがあること、数字が集計されていること、発見が断定形で言語化されていること、表と結論で構造化されていることです。この4つは順番も大切で、データありきではなく問いありきで始めます。
データを「読み物」に変える4つの条件
| 条件 | 満たしている状態 | 満たしていないと起きること |
|---|---|---|
| 1. 問いがある | 「AIを社内で定着させた会社と止まった会社は何が違うか」のように、読者が知りたい問いから始まっている | 数字の羅列になり、読者が「で、何が言いたいのか」で離脱する |
| 2. 集計されている | 既存データから問いに答える数字を抜き出してある。表計算ソフトで足り、高度な統計は不要 | 生データのままで、AIも人も要点を抜き出せない |
| 3. 断定形で言語化されている | 「〇〇は△△である」と、データから分かったことが1文で書かれている | 「〜と考えられる」の連続で、引用可能な1文が無い |
| 4. 表と結論で構造化されている | HTMLの表か箇条書きで整理され、末尾に「この結果から言えること」がある | 結論が本文に埋もれ、AIが要約の材料にしても引用元にはしない |
どこまで細かく設計するかは記事の目的で変わりますが、4つのうち1つでも欠けると引用のされ方が変わります。とくに3番目の「断定形の1文」は、第2章の定義文と同じで、文脈なしに引用できる形にしておくことがAI検索での扱われ方を左右します。
表・単位・要約で「引用されやすさ」を上げる
AI検索が引用元を選ぶとき、構造化された情報は自由記述より扱いやすい形です。実践するときの観点は3つあります。1つ目は、表に必ず見出し行をつけること。「項目」「数値」「補足」のようなヘッダーがあると、データの意味が読み手にもAIにも伝わります。2つ目は、数値に単位と期間を明記すること。「伸びた」ではなく「何年度に前年比で何パーセント」と書きます。あいまいな表現は引用の対象から外れやすくなります。3つ目は、表の直前か直後に1〜2文の要約を置くこと。「以下の表は〇〇を示している」「この結果から〇〇と言える」という文があると、要約ごと引用される形になります。
引用されたかどうかを測らないと、続かない
構造化した一次情報がAI検索にどれだけ引用されたかは、測らなければ分かりません。総務省の令和7年版 情報通信白書では、生成AI導入の懸念事項の1位が「効果的な活用方法がわからない」で、効果が見えないことが止まる場所になっています。記事でも同じで、AI検索からの流入をGA4でAI検索トラフィックとして測る仕組みがあると、どの一次情報が引用されたかが分かり、次の素材を選ぶ根拠になります。測っていない会社では、一次情報記事の効果が「何となく良さそう」で終わり、3か月後に量産に戻ります。
月1本でも続けるための仕組みづくり
一次情報コンテンツの最大の壁は「続かない」ことです。完璧なデータを待たず、日常の仕事の中から素材を拾う仕組みを作れば、月1本の発信は現実的な量です。仕組みの本質は、記事を書く時間を増やすことではなく、素材が勝手に貯まる場所を1つ決めることにあります。
完璧なデータを待たない
一次情報コンテンツに「完璧なデータ」は必要ありません。学術論文なら統計的な裏付けが求められますが、事業者のブログなら「顧客10社に聞いた結果」で十分に説得力があります。大事なのは回答数の大きさではなく、自分たちの目で見た事実が含まれているかどうかです。「まだデータが足りないから」と待っている間に、月30時間は二次情報の記事に流れ続けます。
回りやすい3つの仕組み
週1回の「ネタ出しメモ」。営業やカスタマーサポートが「今週お客さんに聞かれたこと」をチャットや表計算に1行残します。月末にまとめれば、そのまま記事の素材になります。営業日報に「今日いちばん気になった商談メモ」の欄を1行足すだけで、素材は貯まり始めます。
四半期に1回の顧客アンケート。無料フォームで5問、回答時間3分ほどの設問を既存顧客に送ります。回収数は業種と関係性で変わりますが、四半期に1本のレポート記事を書く材料としては、数十件で足ります。
社内勉強会の記事化。社内で共有している業界知識や新しい技術の話を、外部向けに書き直します。社内資料がすでに存在するため、ゼロから書くより手間が小さく済みます。こうして貯まる記事は、トピッククラスターとピラーページの設計を意識して体系的につなげると、1本ずつ孤立させるよりサイト全体の評価に効きます。
発信の仕組みも「会社の決めごと」にする
仕組みが続くかどうかは、個人の熱意ではなく会社の決めごとになっているかで決まります。総務省の令和7年版 情報通信白書では、生成AIの活用方針を定めている企業は49.7%と半数に届いていません。商工中金の2026年1月調査でも、「会社での導入はなく、使用は個人の判断に任せている」中小企業が64.9%を占め、課題の最多は「具体的な活用場面が不明」の35.6%です。AIの使い方が個人任せの会社では、一次情報の発信も担当者1人の頑張りに依存し、その人が忙しくなった月に止まります。「週1のメモを誰が集めるか」「四半期のアンケートを誰が送るか」を、会社として決めておくことが、月1本を1年続けるための条件です。
自前だけで一次情報を出し続けると、どこで止まるのか?
ここからが本題です。素材の場所も分かり、4つの条件も理解した会社が、半年から1年のあいだに静かに止まる場所が3つあります。3つとも「記事は出ているように見える」まま止まるため、気づくのが遅れます。
止まる場所1:素材はあるのに「どれを記事にするか」が決まらない
週1のメモが3か月分貯まると、素材は数十件になります。ここで「どの素材が検索で読まれる問いに対応するか」「どの切り口ならAI検索に引用される形になるか」を決めるには、検索意図とコンテンツ設計の見立てが必要です。この見立てが社内に無いと、素材は貯まったまま、書きやすい二次情報の記事に戻ります。素材が無いのではなく、素材を選ぶ基準が無いために止まる、という順序です。
止まる場所2:数字の扱いを誤って、信頼を落とす
一次情報の記事は数字を出す記事です。出典の無い数字、期間と母数の無い割合、匿名化されていない顧客の情報、実際より大きく見せた前後比較。これらは1つでも入ると、記事全体の信頼を落とします。E-E-A-Tの「信頼性」は、数字を出すこと自体ではなく、数字の出どころが示されているかで測られます。自前で回すときに一番見落とされるのがこの確認で、公開後に指摘を受けてから直す会社は、次の一次情報記事を出すのが怖くなり、そこで止まります。
止まる場所3:引用されたかを測れず、3か月で量産に戻る
一次情報の記事は、書く時間が二次情報より長くなります。本記事の目安では1本6時間が10時間ほどになります。その4時間の差を続けるには、「引用された」「AI検索から流入が来た」という結果が見えている必要があります。測る仕組みが無いと、経営側からは「時間のかかる記事」にしか見えず、3か月後に月5本の量産に戻ります。効果が見えないまま止まるのは、第4章で触れた総務省の懸念事項1位「効果的な活用方法がわからない」と同じ形です。
3つの止まる場所を、任せる範囲と決める範囲の表に落とす
| 止まる場所 | 自前だけで続けると起きること | 先に決めておくこと |
|---|---|---|
| 素材の選び方 | 数十件のメモが貯まったまま、書きやすい二次情報に戻る | 検索意図と引用される形から逆算して、素材を選ぶ基準を持つ |
| 数字の確認 | 出典・母数・匿名化の漏れが公開後に見つかり、次が怖くなる | 公開前に「出どころ・期間・母数・匿名化」の4点を確認する人を決める |
| 効果の測定 | 1本10時間の記事が「時間のかかる記事」に見え、3か月で量産に戻る | AI検索からの流入と引用を月1回数える型を先に作る |
| 共通 | 記事は出ているように見えるまま、月30時間が要約に吸われる状態に戻る | 浮いた時間を何の素材集めに回すかまで含めた設計 |
表の右側が埋まっていれば、担当者が変わっても一次情報の発信は続きます。右側が空欄のまま始めると、最初の3か月は勢いで出せますが、半年後には量産に戻ったうえに、貯めた素材が使われないまま古くなります。自社だけで回すか外部と並走するかは、右側を社内で埋め続けられるかで決めるのが現実的です。BoostXがAI顧問を提供する中で重視しているのも、記事の代筆ではなく、この右側を最初の1か月で一緒に埋めることです。
ビフォーアフター:一次情報を置くと記事の行き先はこう変わる
記事1本6時間・月5本=月30時間の会社を置いて、一次情報を組み込む前後で1か月がどう変わるかを見ます。数字は本記事で置いた一般的な目安で、特定の会社の実績ではありません。
月5本・30時間が二次情報のまま、AIの要約に吸われる
月5本の記事は、いずれも公開情報をAIに要約させて整えた二次情報です。1本6時間、月30時間をかけていますが、検索結果には同じ構成の競合記事が並び、AI検索の回答には引用されません。読者はAIの要約で用を足し、記事は表示回数だけが増えてクリックされない状態です。営業日報や問い合わせ履歴には素材が貯まっていますが、「コンテンツの素材」として見る視点が無いため使われていません。効果を測る仕組みも無く、30時間が投資なのか浪費なのかを誰も答えられません。
月3本・22時間で、自社データ入りの記事が月1本残る
月の本数を5本から3本に減らし、そのうち1本を自社データ入りの記事に置き換えます。一次情報の記事は集計と確認が加わるため1本10時間、残り2本の二次情報記事は6時間ずつで、合計は月22時間です。Beforeとの差は月8時間で、その8時間は週1のメモ集めと四半期アンケートの準備に回ります。自社データ入りの1本は、第2章の「Googleの4つの問い」に「はい」と答えられ、AI検索が引用元として選びうる形になっています。素材の選び方、数字の確認、月1回の効果測定は会社の決めごとになっており、担当者が変わっても続きます。
| 比較項目 | Before(二次情報だけの量産) | After(一次情報を月1本組み込む) |
|---|---|---|
| 月の本数と時間 | 5本・30時間(6時間×5本) | 3本・22時間(10時間×1本+6時間×2本) |
| AI検索に引用されうる記事 | 0本 | 月1本・年12本 |
| Googleの自己評価4問への答え | 4問とも「いいえ」 | 4問とも「はい」 |
| 社内データ | 貯まっているが使われない | 週1メモ・四半期アンケートで素材として回る |
| 効果の記録 | 無し・30時間が投資か浪費か分からない | AI検索流入と引用を月1回数え、続ける・止めるを判断できる |
違いを生むのはツールではなく、素材の出どころ
BeforeとAfterで使っている生成AIは同じです。分けているのは、素材が公開情報か自社データかという出どころと、それを選ぶ基準・確認する人・測る型の3つが会社の決めごとになっているかどうかだけです。うちはまだBefore寄りだと感じた方は、まず先月公開した記事を並べて、「この記事にしか無い数字や事実は何か」を1本ずつ書き出してみてください。書き出せなかった本数が、そのままAIに要約されて終わっている記事の本数です。
よくある質問
QAIは私のデータの変化を要約できますか?
Aできます。月別の件数やアンケート回答を渡せば、前月との差や傾向の変化を文章にまとめるのは生成AIの得意な作業です。ただし、そのデータ自体はAIの学習データに無いため、要約した結果はそのまま一次情報になります。氏名や連絡先を含む生データは入力せず、集計済みか匿名化した形に整えてから渡してください。
QAIO対策で1次情報はなぜ必要なのですか?
AAIはすでに一般的な情報を持っているため、外部の記事を引用するのは、そこにAI自身が持っていない情報があるときだけだからです。Googleも「AI を使用したからといってランキングに関して特別なメリットがあるわけではない」と明示し、独自の情報や分析を提示しているかを自己評価の問いに置いています。二次情報だけの記事は要約の材料にされて終わり、1次情報のある記事だけが引用元に選ばれます。
Q独自データのコンテンツ化にはお金がかかりますか?
A社内データの集計と記事化なら、追加費用はほぼかかりません。営業日報や問い合わせ履歴をまとめるだけでも一次情報になります。外部向けのアンケートを行う場合も、無料のフォームを使えば費用は小さく済みます。かかるのはお金より時間で、本記事の目安では一次情報の記事1本に二次情報より4時間ほど余分にかかります。
Q競合にデータを知られるリスクはありませんか?
A全体の傾向データは公開しても競争力を損なわない場合がほとんどです。問い合わせの内訳の割合や所要時間の前後比較のような傾向値は出し、個別の顧客名・契約条件・価格の内訳・顧客リストは守る、という2段階の線引きで足ります。むしろ傾向を公開することで、自社のデータを持っている会社としての信頼につながります。
Qデータ分析の知識がなくても一次情報の記事は作れますか?
A作れます。高度な統計処理は不要で、アンケートの回答を割合にする、問い合わせの月別件数を並べる、といった表計算ソフトの基本操作で十分です。難しいのは分析ではなく、どの素材を記事にするかの選び方と、出典・期間・母数・匿名化の確認で、自前で続けるときに止まるのもこの2点です。
この記事のまとめ
- AIに引用される記事と要約されて終わる記事の境目は、一次情報(自社でしか持っていないデータ・事実・知見)が本文にあるかどうか。Googleは「AI を使用したからといってランキングに関して特別なメリットがあるわけではない」と明示している(Google 検索セントラル、2023年2月公表)
- 日本企業の55.2%が生成AIを使い、中小企業の活用事例は「メール・報告書・議事録の作成・要約」74.0%、リサーチは20.2%(総務省 令和7年版 情報通信白書・商工中金 2026年1月調査)。同じ公開情報を同じAIに要約させる使い方が主流のため、均質化は構造的に起きる
- 営業日報・問い合わせ履歴・顧客アンケート・業務ログ・社員の暗黙知の5つは、すでに社内にある一次情報の素材。傾向は出す、個別の詳細は守る、の線引きで公開できる
- 引用される形に変わる条件は、問い・集計・断定形の言語化・表と結論の構造化の4つ。Googleの自己評価4問(独自の情報・付加価値・実体験・実質的な価値)に「はい」と答えられる記事になる
- 本記事の目安では、月5本・30時間の二次情報量産を月3本・22時間に変え、1本を自社データ入りにすると、引用されうる記事が月1本残る。自前だけで止まるのは素材の選び方・数字の確認・効果の測定の3つで、この3つを会社の決めごとにできるかで自社か並走かを決める
公開日:2026年9月
読んで終わりにしないために
「自社の場合は、どうすれば?」
その答えを、最大45分で持ち帰る。
記事で分かるのは、一般論まで。AI導入を専門に見ている担当が、貴社の業務に当てはめて“次の一手”だけを一緒に整理します。
この相談で持ち帰れるもの
- 01
自社業務に当てはめたAI活用マップ
- 02
投資対効果(ROI)のシミュレーション
- 03
いまの悩み・疑問への、その場の個別回答


